VLA چیست؟ چگونه رباتها میبینند، زبان را میفهمند و عمل میکنند؟
تا همین چند سال قبل، اگر میخواستیم یک ربات کاری را انجام دهد، معمولاً باید مسیر حرکت، شرایط محیط و رفتارهای موردنظر آن را تا حد زیادی از قبل مشخص میکردیم.
اما نسل جدید رباتها در حال تغییر این مدل است.
امروز مدلهای هوش مصنوعی میتوانند تصویر محیط، دستور زبان طبیعی و وضعیت خود ربات را دریافت کنند و در نهایت تصمیمی تولید کنند که به حرکت واقعی ربات منجر شود.
یکی از مهمترین فناوریهایی که این تغییر را ممکن کرده، VLA است.
VLA مخفف:
Vision-Language-Action
یعنی:
بینایی + زبان + عمل
است.
به زبان ساده، یک مدل VLA تلاش میکند فاصله میان چیزی که ربات میبیند، چیزی که انسان میگوید و کاری که ربات باید انجام دهد را کم کند.
برای مثال، اگر به یک ربات بگوییم:
«بطری قرمز را بردار و داخل جعبه بگذار.»
یک سیستم VLA باید بتواند دستور را بفهمد، بطری قرمز را در تصویر پیدا کند، جعبه را تشخیص دهد، شرایط محیط را بررسی کند و در نهایت فرمانهای لازم برای انجام این کار را تولید کند.
این فناوری یکی از پایههای مهم Physical AI و رباتیک عمومیتر به شمار میرود.
VLA دقیقاً چیست؟
VLA یا Vision-Language-Action یک نوع مدل هوش مصنوعی برای رباتیک است که اطلاعات بصری، دستورهای زبانی و دادههای مربوط به وضعیت ربات را به رفتار یا عمل رباتیک مرتبط میکند.
یک مدل ساده را میتوان به شکل زیر تصور کرد:
دوربین + دستور انسان + وضعیت ربات
↓
VLA
↓
فرمان حرکت
↓
کنترلر ربات
↓
موتور و عملگر
در این معماری، مدل دیگر فقط نمیگوید «این شیء یک بطری است».
بلکه باید بتواند از این تشخیص برای انجام یک کار فیزیکی استفاده کند.
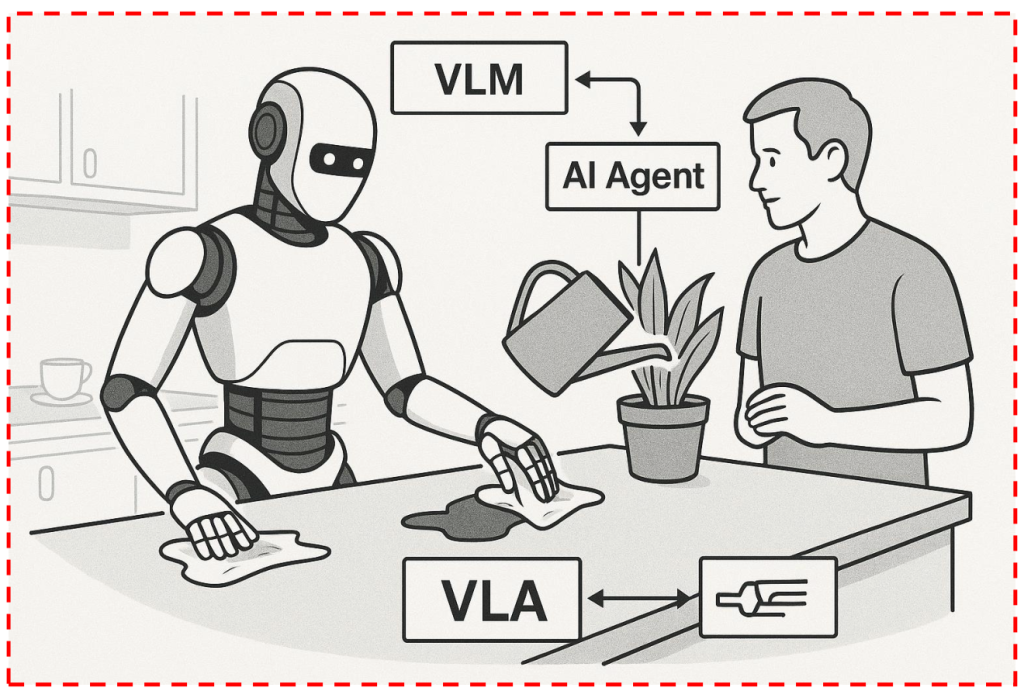
به همین دلیل VLA تفاوت مهمی با یک مدل Vision-Language معمولی دارد.
یک VLM میتواند تصویر را ببیند و درباره آن توضیح دهد؛ اما VLA باید یک مرحله جلوتر برود و برای انجام عمل در دنیای واقعی خروجی مناسب تولید کند.
Google DeepMind نیز VLA را مدلی معرفی میکند که ورودیهای بینایی و زبان را به کنترل حرکتی ربات تبدیل میکند. در نسل فعلی Gemini Robotics 2، این قابلیت برای رباتهایی با شکلهای مختلف، از بازوهای رباتیک تا رباتهای انساننما، توسعه داده شده است.
تفاوت VLM، LLM و VLA چیست؟
برای درک بهتر VLA، بهتر است سه مفهوم را از هم جدا کنیم.
LLM
Large Language Model
مدل زبانی بزرگ است.
ورودی اصلی آن متن است و خروجی آن نیز معمولاً متن است.
برای مثال:
ورودی:
«چگونه یک موتور DC را کنترل کنیم؟»
خروجی:
توضیح درباره PWM، درایور موتور و کنترل سرعت.
VLM
Vision-Language Model
مدل بینایی-زبانی است.
این مدل علاوه بر متن، تصویر را نیز درک میکند.
برای مثال میتواند یک تصویر را دریافت کند و بگوید:
- یک ربات در تصویر وجود دارد.
- سه جعبه روی میز قرار دارد.
- بطری قرمز کنار جعبه آبی است.
اما الزاماً نمیتواند مستقیماً آن اطلاعات را به حرکت فیزیکی ربات تبدیل کند.
VLA
VLA یک مرحله دیگر جلو میرود.
ورودی میتواند شامل:
- تصویر
- متن
- وضعیت ربات
- دادههای سنسورها
باشد و خروجی میتواند شامل عمل یا فرمان رباتیک باشد.
بنابراین به صورت ساده:
LLM
متن → متن
VLM
تصویر + متن → اطلاعات/پاسخ
VLA
تصویر + زبان + وضعیت ربات → عمل
البته معماری واقعی مدلهای مدرن پیچیدهتر از این نمایش ساده است.
یک مثال واقعی از عملکرد VLA
فرض کنیم یک ربات دو بازویی روی یک میز قرار دارد.
روی میز این اشیا وجود دارند:
- یک لیوان
- یک بطری
- یک جعبه
- چند قطعه کوچک
کاربر میگوید:
«بطری را بردار و داخل جعبه بگذار.»
ربات باید چند مسئله را حل کند.
مرحله اول: درک دستور
مدل باید بفهمد منظور از «بطری» چیست و «داخل جعبه بگذار» چه توالی عملیاتی را مشخص میکند.
مرحله دوم: درک تصویر
ربات باید بطری و جعبه را در تصویر پیدا کند.
مرحله سوم: تعیین موقعیت
سیستم باید موقعیت نسبی بطری، ربات و جعبه را تخمین بزند.
مرحله چهارم: انتخاب حرکت
ربات باید تصمیم بگیرد بازوی خود را چگونه حرکت دهد.
مرحله پنجم: گرفتن شیء
دست یا گریپر باید به موقعیت مناسب برسد و بطری را با نیروی مناسب بگیرد.
مرحله ششم: انتقال
ربات باید مسیر مناسبی را برای انتقال بطری انتخاب کند.
مرحله هفتم: رها کردن
در نهایت بطری باید در موقعیت مناسب داخل جعبه قرار بگیرد.
اما نکته مهم این است که محیط واقعی ممکن است دقیقاً مطابق انتظار نباشد.
بطری ممکن است کمی جابهجا شود.
جعبه ممکن است در زاویه دیگری قرار گرفته باشد.
یک مانع ممکن است وارد مسیر شود.
نور محیط ممکن است تغییر کند.
VLA باید بتواند تا حدی خود را با این تغییرات تطبیق دهد.
VLA چگونه از تصویر به حرکت میرسد؟
این قسمت یکی از مهمترین بخشهای معماری VLA است.
به صورت ساده میتوان مسیر را اینگونه نمایش داد:
Camera
↓
Visual Encoder
↓
Multimodal Representation
↓
Language / Task Understanding
↓
Policy / Action Model
↓
Robot Action
اما در یک ربات واقعی معمولاً این فرآیند به سیستم کنترل نیز متصل میشود.
بنابراین معماری کلی میتواند چیزی شبیه این باشد:
Camera / Sensors
↓
Perception
↓
VLA
↓
Task / Motion Planning
↓
Controller
↓
Motor Driver
↓
Actuators
↓
Robot
↓
Sensor Feedback
و دوباره اطلاعات جدید به سیستم برمیگردد.
این همان حلقهای است که باعث میشود ربات فقط یک دستور را یک بار اجرا نکند، بلکه بتواند در حین اجرای کار وضعیت محیط را دوباره ارزیابی کند.
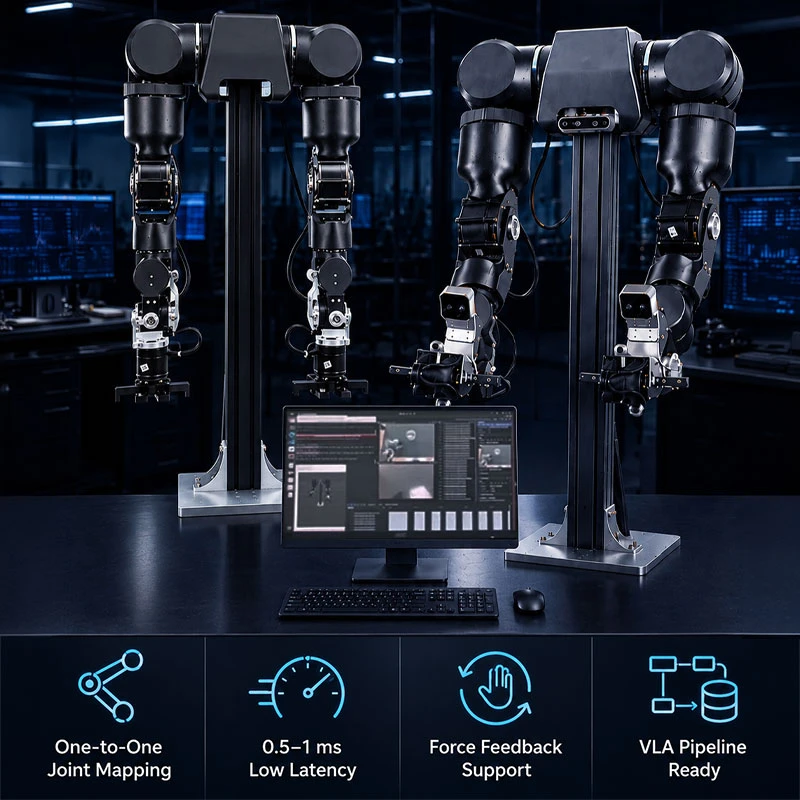
آیا VLA مستقیماً موتور را کنترل میکند؟
لزومی ندارد.
این یکی از سوءبرداشتهای رایج درباره VLA است.
وقتی میگوییم VLA «ربات را کنترل میکند»، الزاماً به این معنی نیست که مدل مستقیماً PWM موتور را تولید میکند.
در یک معماری مهندسیشده، ممکن است VLA خروجی سطح بالاتری تولید کند؛ مثلاً:
دست راست → حرکت به سمت موقعیت X,Y,Z
یا:
گریپر → گرفتن جسم
سپس لایههای پایینتر این فرمان را به مسیر حرکتی و در نهایت فرمان موتور تبدیل میکنند.
برای مثال:
VLA
→ هدف حرکتی
Motion Planner
→ مسیر
Inverse Kinematics
→ زوایای مفاصل
Controller
→ فرمان موتور
Motor Driver
→ جریان/ولتاژ
Motor
→ حرکت
این تفکیک اهمیت زیادی دارد، زیرا مدل هوش مصنوعی برای تصمیمگیری مناسب است، اما کنترل دقیق و ایمن موتور به سیستمهای کنترل اختصاصی نیاز دارد.
نقش دادههای وضعیت خود ربات چیست؟
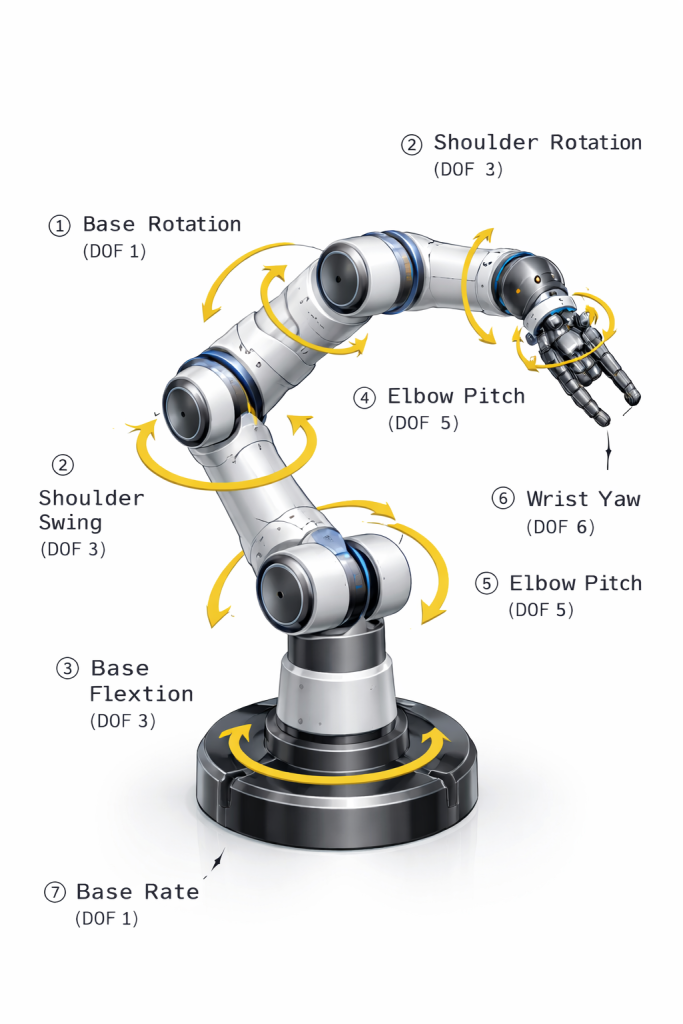
ربات فقط محیط را نمیبیند؛ باید بداند خودش در چه وضعیتی قرار دارد.
به این دسته از اطلاعات معمولاً Proprioception گفته میشود.
برای مثال:
- زاویه مفاصل
- سرعت مفاصل
- وضعیت گریپر
- شتاب
- موقعیت بازو
- گشتاور
- وضعیت چرخها
میتوانند بخشی از ورودی سیستم باشند.
در مدلهای جدید VLA، این دادهها میتوانند در کنار تصویر و زبان استفاده شوند.
برای نمونه، مدل Gemini Robotics On-Device 2 علاوه بر تصویر و متن، دادههای proprioception ربات را نیز به عنوان ورودی دریافت میکند و خروجی آن شامل دادههای مربوط به عمل ربات است.
این موضوع اهمیت زیادی دارد، چون دو ربات ممکن است یک تصویر یکسان ببینند اما در موقعیتهای کاملاً متفاوتی قرار داشته باشند.
VLA از کجا یاد میگیرد؟
یکی از سختترین قسمتهای توسعه VLA، داده آموزشی است.
برای یک مدل زبانی میتوان حجم عظیمی از متن موجود در اینترنت را استفاده کرد.
اما برای رباتیک، فقط متن کافی نیست.
مدل باید نمونههایی از رابطه میان:
مشاهده → دستور → حرکت → نتیجه
را یاد بگیرد.
برای همین، دادههای رباتیک میتوانند شامل موارد زیر باشند:
- ویدئو
- تصویر دوربین ربات
- دستور زبان طبیعی
- موقعیت مفاصل
- حرکت بازو
- فرمان گریپر
- اطلاعات سنسورها
- نتیجه موفق یا ناموفق بودن کار
به عنوان مثال، یک نمونه آموزشی میتواند چیزی شبیه این باشد:
Instruction:
«لیوان را بردار.»
Observation:
تصویر میز و لیوان.
Robot State:
زاویه فعلی مفاصل.
Action:
حرکت بازو + بسته شدن گریپر.
مدل با دیدن تعداد زیادی نمونه یاد میگیرد که چه رابطهای میان شرایط محیط و عمل مناسب وجود دارد.
چرا جمعآوری داده رباتیک سخت است؟
این یکی از مهمترین تفاوتهای AI فیزیکی با AI دیجیتال است.
برای ساخت یک مدل زبان میتوان از دادههای موجود استفاده کرد.
اما برای آموزش یک ربات عمومی، باید ربات واقعاً در محیط فیزیکی حرکت کند.
هر نمونه میتواند شامل:
- زمان
- تصویر
- وضعیت مفاصل
- فرمانها
- نیرو
- موقعیت
- نتیجه عملیات
باشد.
از طرف دیگر، خراب شدن تجهیزات، زمان اپراتور و محدودیت تعداد رباتها هزینه زیادی ایجاد میکند.
به همین دلیل شرکتهای فعال در این حوزه به سمت استفاده ترکیبی از:
Real Data + Simulation Data + Demonstration Data
حرکت کردهاند.
Teleoperation چیست و چرا در آموزش رباتها مهم است؟
یکی از روشهای جمعآوری داده، Teleoperation است.
در این روش یک انسان ربات را از راه دور یا با تجهیزات کنترلی هدایت میکند.
حرکت انسان به عنوان نمونهای از رفتار صحیح ثبت میشود.
برای مثال:
اپراتور بازوی ربات را حرکت میدهد.
↓
دوربین وضعیت محیط را ثبت میکند.
↓
موقعیت مفاصل و گریپر ذخیره میشود.
↓
دستور مربوط به کار ثبت میشود.
↓
یک Demonstration ایجاد میشود.
تعداد زیادی از این Demonstrationها میتوانند برای آموزش مدل استفاده شوند.
این روش بهخصوص برای کارهایی که تعریف دقیق الگوریتمی آنها دشوار است اهمیت دارد.
چرا Simulation برای VLA اهمیت دارد؟
فرض کنید بخواهیم یک ربات را برای برداشتن هزاران نوع شیء آموزش دهیم.
اجرای همه این سناریوها روی ربات واقعی بسیار پرهزینه است.
در شبیهسازی میتوان:
- صدها ربات مجازی ساخت
- هزاران محیط تولید کرد
- اشیا را تصادفی قرار داد
- نور محیط را تغییر داد
- اصطکاک را تغییر داد
- شرایط مختلف ایجاد کرد
- میلیونها آزمایش انجام داد
سپس میتوان بخشی از مهارت آموختهشده را به ربات واقعی منتقل کرد.
این همان ایده Sim-to-Real است.
NVIDIA در اکوسیستم Isaac GR00T از ترکیب داده واقعی، داده شبیهسازیشده و ابزارهای آموزش و ارزیابی برای توسعه مدلهای رباتیک استفاده میکند. در GR00T 1.7 نیز NVIDIA یک مدل VLA برای مهارتهای عمومی رباتهای انساننما ارائه کرده است.
VLA و Transformer چه ارتباطی دارند؟
بسیاری از مدلهای VLA مدرن از معماریهایی استفاده میکنند که ریشه آنها در مدلهای Transformer و مدلهای چندوجهی است.
ایده اصلی Transformer این است که مدل بتواند ارتباط میان بخشهای مختلف یک توالی را یاد بگیرد.
در VLA، این توالی دیگر فقط کلمات نیست.
میتواند شامل:
تصویر + متن + وضعیت ربات + تاریخچه اقدامات
باشد.
بنابراین مدل باید رابطه میان این اطلاعات را یاد بگیرد.
مثلاً:
«این شیء در این موقعیت قرار دارد، کاربر چنین دستوری داده، ربات در این وضعیت قرار دارد و حرکت مناسب بعدی این است.»
البته همه VLAها دقیقاً یک معماری ندارند و روشهای مختلفی برای تولید Action وجود دارد.
پژوهشهای جدید VLA معماریهایی مانند روشهای autoregressive، diffusion و معماریهای ترکیبی را بررسی میکنند.
Action در VLA دقیقاً چیست؟
کلمه Action ممکن است کمی گمراهکننده باشد.
Action الزاماً به معنی یک فرمان ساده مثل «حرکت کن» نیست.
بسته به معماری سیستم، Action میتواند شامل اطلاعاتی مانند:
- موقعیت هدف
- سرعت
- جهت حرکت
- زاویه مفاصل
- وضعیت گریپر
- گشتاور
- trajectory
- یا مجموعهای از فرمانهای پیوسته
باشد.
به همین دلیل نحوه نمایش Action یکی از موضوعات مهم پژوهشی در VLA است.
اگر مدل فقط بگوید:
«لیوان را بردار»
هنوز مسئله حل نشده است.
سیستم باید این هدف را به مجموعهای از حرکات قابل اجرا تبدیل کند.
VLA با مدل زبانی چه تفاوتی در تصمیمگیری دارد؟
مدل زبانی میتواند درباره یک کار توضیح دهد.
مثلاً:
«برای برداشتن لیوان، ابتدا دست را به سمت لیوان ببرید و سپس گریپر را ببندید.»
اما VLA باید این دانش را به رفتار تبدیل کند.
یعنی:
دانستن اینکه چه کاری باید انجام شود
با
توانایی انجام دادن آن کار
متفاوت است.
این همان جایی است که مفهوم Embodied Intelligence اهمیت پیدا میکند.
روبات باید نه فقط درباره جهان اطلاعات داشته باشد، بلکه بتواند با آن تعامل کند و از نتیجه تعامل خود بازخورد بگیرد.
آیا VLA واقعاً «فکر میکند»؟
این سؤال نیاز به دقت دارد.
وقتی درباره «فکر کردن» ربات صحبت میکنیم، نباید آن را با آگاهی یا تفکر انسانی یکی بدانیم.
مدل میتواند الگوهای پیچیدهای را از دادهها یاد بگیرد و برای رسیدن به هدف، توالیهایی از عملیات را تولید کند.
در نسل جدید سیستمهای رباتیک، حتی معماریهایی شکل گرفتهاند که یک مدل reasoning سطح بالاتر را در کنار VLA قرار میدهند.
برای مثال Google DeepMind در خانواده Gemini Robotics 2 دو نقش متفاوت را تفکیک کرده است:
Gemini Robotics 2
مدل VLA برای تبدیل ورودیهای بینایی و زبان به عمل ربات.
Gemini Robotics ER 2
مدل Embodied Reasoning برای درک محیط و برنامهریزی کارهای چندمرحلهای.
در این معماری، مدل reasoning میتواند برنامه کلیتر را تعیین کند و VLA اجرای حرکتی را بر عهده بگیرد.
این تفکیک از نظر معماری بسیار جالب است:
Reasoning Model
«چه کاری باید انجام شود؟»
↓
VLA
«چگونه این کار را با بدن ربات انجام دهم؟»
آیا VLA فقط برای ربات انساننماست؟
خیر.
VLA یک مفهوم عمومیتر از Humanoid Robotics است.
این مدلها میتوانند برای:
- بازوی صنعتی
- ربات دو بازویی
- ربات متحرک
- ربات انساننما
- سیستمهای دستکاری اشیا
- برخی پهپادها
- رباتهای خدماتی
استفاده شوند.
پژوهشهای جدید حتی استفاده از VLA در رباتهای هوایی و سیستمهای دو بازویی را نیز بررسی کردهاند.
بنابراین نباید VLA را مترادف «ربات انساننما» دانست.
VLA بیشتر یک رویکرد نرمافزاری و مدل هوش مصنوعی برای اتصال ادراک، زبان و عمل است.
چرا قابلیت Generalization اهمیت دارد؟
یکی از بزرگترین مشکلات رباتهای سنتی این است که برای یک وظیفه مشخص بسیار خوب هستند، اما خارج از همان وظیفه عملکردشان افت میکند.
مثلاً:
ربات برای برداشتن قطعات فلزی آموزش دیده است.
اما اگر یک قطعه پلاستیکی با شکل متفاوت مقابل آن قرار گیرد، ممکن است نتواند کار را انجام دهد.
هدف VLAهای عمومیتر این است که بتوانند دانش خود را به:
- اشیای جدید
- محیطهای جدید
- دستورات جدید
- رباتهای متفاوت
تعمیم دهند.
به این قابلیت Generalization گفته میشود.
البته این به معنی حل کامل مشکل نیست.
هنوز هم مدلهای VLA در محیطهای ناشناخته و وظایف جدید محدودیتهای جدی دارند.
یک اتفاق مهم در ۲۰۲۶: انتقال مدل بین رباتهای مختلف
یکی از چالشهای قدیمی رباتیک این بوده که یک مدل آموزشدیده روی یک ربات را نمیتوان بهسادگی روی ربات دیگری اجرا کرد.
چون رباتها ممکن است:
- تعداد مفاصل متفاوت داشته باشند.
- شکل متفاوتی داشته باشند.
- سنسورهای متفاوت داشته باشند.
- گریپر متفاوت داشته باشند.
- محدودیت حرکتی متفاوت داشته باشند.
اما مدلهای جدید به سمت Multi-Embodiment حرکت کردهاند.
برای نمونه، Google DeepMind اعلام کرده است که Gemini Robotics On-Device 2 میتواند با رباتهای جدید سازگار شود و برای برخی بدنههای جدید تنها به چند ساعت داده سازگاری نیاز داشته باشد؛ این شرکت در نمونههای خود از کمتر از ۲۰۰ نمونه برای برخی سازگاریها صحبت کرده است.
اگر این روند در مقیاس صنعتی قابل اتکا شود، اهمیت بسیار زیادی خواهد داشت.
زیرا در آینده شاید لازم نباشد برای هر مدل ربات، یک «مغز هوش مصنوعی» کاملاً جداگانه از صفر آموزش داده شود.
Edge VLA؛ وقتی مدل روی خود ربات اجرا میشود
یکی از چالشهای استفاده از مدلهای بزرگ در رباتیک، اتصال اینترنت است.
فرض کنید ربات باید در چند میلیثانیه نسبت به یک مانع واکنش نشان دهد.
ارسال تصویر به سرور:
Robot → Internet → Cloud → AI → Internet → Robot
میتواند تأخیر و وابستگی به شبکه ایجاد کند.
به همین دلیل اجرای VLA روی خود سختافزار ربات اهمیت پیدا کرده است.
Gemini Robotics On-Device 2 نمونهای از این روند است؛ این مدل برای اجرای محلی روی سختافزار ربات بهینه شده و هدف آن کاهش وابستگی به اتصال شبکه است.
این موضوع در محیطهای صنعتی، انبارها و کاربردهایی که اتصال پایدار اینترنت وجود ندارد، اهمیت ویژهای دارد.
محدودیتهای VLA چیست؟
با وجود پیشرفتهای زیاد، VLA هنوز یک فناوری کامل و بدون خطا نیست.
مهمترین چالشها عبارتاند از:
۱. کمبود داده واقعی
جمعآوری داده رباتیک بسیار گرانتر از جمعآوری متن و تصویر است.
۲. خطا در درک محیط
نور، بازتاب، انسداد و اشیای مشابه میتوانند باعث خطا شوند.
۳. کنترل دقیق
تشخیص صحیح یک شیء لزوماً به معنی توانایی گرفتن آن نیست.
۴. ایمنی
یک تصمیم اشتباه در ربات میتواند پیامد فیزیکی داشته باشد.
۵. تعمیم به محیط ناشناخته
عملکرد مدل در محیط آزمایشگاهی ممکن است با محیط واقعی متفاوت باشد.
۶. هزینه محاسبات
اجرای مدلهای بزرگ با تأخیر کم به سختافزار قدرتمند نیاز دارد.
۷. Sim-to-Real Gap
رفتار فیزیکی محیط شبیهسازیشده دقیقاً با دنیای واقعی یکسان نیست.
به همین دلیل مسیر رسیدن از یک Demo جذاب به یک محصول صنعتی قابل اعتماد هنوز طولانی است.
آینده VLA به کجا میرود؟
احتمالاً VLAها یکی از اجزای مهم معماری رباتهای آینده خواهند بود، اما احتمالاً به تنهایی تمام سیستم را تشکیل نمیدهند.
معماری آینده میتواند چیزی شبیه این باشد:
Foundation Model
↓
Embodied Reasoning
↓
VLA
↓
World Model
↓
Motion Planning
↓
Control
↓
Robot
در چنین معماریای:
- مدل reasoning هدف را مشخص میکند.
- VLA محیط و دستور را به عمل مرتبط میکند.
- World Model رفتار احتمالی محیط را پیشبینی میکند.
- Motion Planner مسیر را محاسبه میکند.
- Controller حرکت دقیق را اجرا میکند.
حتی مفهوم World Action Model نیز در حال مطرح شدن است؛ مدلی که به جای اینکه صرفاً مشاهده و دستور را مستقیماً به Action تبدیل کند، تلاش میکند تغییرات آینده جهان و اثر احتمالی اقدامات ربات را نیز مدل کند. NVIDIA این رویکرد را به عنوان یکی از مسیرهای فراتر از VLAهای مستقیم مطرح کرده است.
VLA چه تغییری در صنعت ایجاد میکند؟
اگر مدلهای VLA بتوانند به سطح بالایی از قابلیت اطمینان و Generalization برسند، روش برنامهریزی رباتها میتواند تغییر کند.
امروز برای بسیاری از سیستمهای رباتیک باید رفتارها به شکل نسبتاً دقیق تعریف شوند.
اما در آینده ممکن است بخشی از تعامل با ربات به زبان طبیعی انجام شود.
برای مثال:
«این قطعات را مرتب کن.»
«محصولات آسیبدیده را جدا کن.»
«میز را برای سرویس بعدی آماده کن.»
«این جعبهها را به بخش بستهبندی منتقل کن.»
ربات باید دستور را بفهمد و آن را به مجموعهای از عملیات تبدیل کند.
این همان نقطهای است که VLA میتواند فاصله میان AI دیجیتال و ماشین فیزیکی را کمتر کند.
جمعبندی
VLA یا Vision-Language-Action یکی از مهمترین ایدههای نسل جدید رباتیک است.
هدف اصلی آن ساده به نظر میرسد:
ربات ببیند، دستور را بفهمد و عمل کند.
اما پشت همین جمله ساده، مجموعه بزرگی از فناوریها قرار دارد:
Computer Vision
Multimodal AI
Language Models
Robot Learning
Motion Planning
Control Systems
Sensor Fusion
Simulation
Edge AI
و Robotics Hardware
مدلهای جدیدی مانند Gemini Robotics 2 و NVIDIA Isaac GR00T نشان میدهند که صنعت در حال حرکت از رباتهای کاملاً برنامهریزیشده به سمت مدلهای عمومیتر و قابل تطبیقتر است.
اما نباید فراموش کرد که یک Demo موفق، با یک ربات صنعتی قابل اعتماد فاصله زیادی دارد.
روبات باید بتواند نه فقط یک بار، بلکه هزاران و میلیونها بار یک کار را با دقت، سرعت، ایمنی و قابلیت پیشبینی انجام دهد.
به همین دلیل آینده VLA فقط به بهتر شدن مدلهای هوش مصنوعی وابسته نیست؛ بلکه به پیشرفت همزمان سنسورها، پردازندهها، موتورهای دقیق، کنترلرها، دادههای رباتیک، شبیهسازی و مهندسی سیستم وابسته است.
و شاید مهمترین اتفاق این باشد که رباتها به تدریج از ماشینهایی که فقط دستورهای از پیش تعریفشده را اجرا میکنند، به ماشینهایی تبدیل شوند که میتوانند محیط را ببینند، دستور را تفسیر کنند و رفتار خود را با شرایط تغییر دهند.
این همان مسیری است که Physical AI را از یک مفهوم نظری به سمت ماشینهای واقعاً هوشمند و قابل استفاده در دنیای واقعی میبرد.
منابع و مطالعه بیشتر
- Google DeepMind — Gemini Robotics 2 و مدل VLA
- Google DeepMind — Gemini Robotics On-Device 2
- NVIDIA — Isaac GR00T 1.7 و توسعه VLA برای رباتهای انساننما
- مرور پژوهشی VLA برای کاربردهای واقعی رباتیک
- مرور سیستماتیک مدلهای VLA در Manipulation